Cuando hablamos de rendimiento en Snowflake, muchas personas piensan en warehouses más grandes o escalado automático. Sin embargo, el verdadero diferencial arquitectónico está en cómo Snowflake almacena y organiza los datos internamente.
El rendimiento no depende de índices tradicionales, sino de:
- Micro-partitions
- Metadatos automáticos
- Data pruning
- Clustering inteligente
Entender estos conceptos es clave para diseñar sistemas eficientes y escalables.
¿Qué son las micro-partitions?
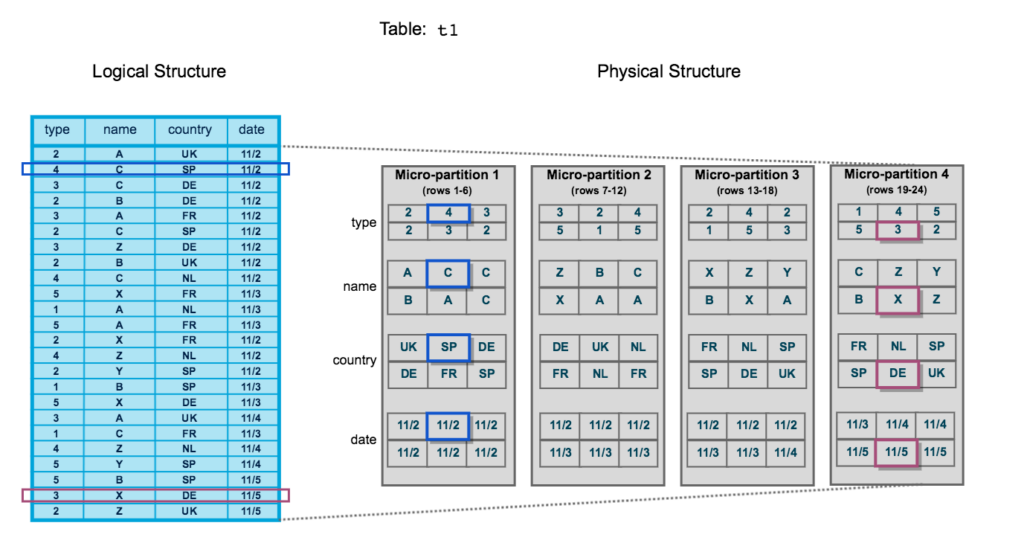
Snowflake divide automáticamente los datos en micro-partitions, que son unidades internas de almacenamiento columnar comprimido.
Cada micro-partition:
- Contiene aproximadamente 50–500 MB de datos sin comprimir
- Es inmutable
- Incluye metadatos detallados por columna
- Se almacena de forma optimizada en la nube
El usuario no las gestiona manualmente. Snowflake se encarga de su creación y organización.
¿Por qué son importantes?
Las micro-partitions permiten:
- Eliminar necesidad de índices manuales
- Optimizar consultas automáticamente
- Mejorar paralelismo
- Soportar Time Travel
- Habilitar Zero-Copy Cloning
Su diseño es la base del modelo copy-on-write.
Metadatos automáticos y Data Pruning
Cada micro-partition almacena información como:
- Valor mínimo y máximo por columna
- Número de valores distintos
- Estadísticas internas
Gracias a esto, Snowflake puede aplicar data pruning automático.
Ejemplo conceptual:
Si ejecutamos:
SELECT *
FROM orders
WHERE order_date = ‘2024-01-01’;
Snowflake:
- Revisa metadatos de cada micro-partition
- Descarta aquellas cuyo rango de fechas no incluye esa fecha
- Solo escanea particiones relevantes
Esto reduce significativamente el volumen de datos leído.
No se necesitan índices. El pruning es automático.
Inmutabilidad y Copy-on-Write
Las micro-partitions son inmutables. Cuando se actualiza un registro:
- No se modifica la partición original
- Se crea una nueva micro-partition
- Se actualizan referencias internas
Esto permite:
- Alta concurrencia
- Versionado eficiente
- Time Travel
- Zero-Copy Cloning
Es un diseño fundamentalmente diferente al de bases de datos tradicionales.
¿Qué es el Clustering?
Snowflake organiza automáticamente los datos al cargarlos. Sin embargo, en tablas muy grandes o con patrones de consulta específicos, puede ser útil definir una clustering key.
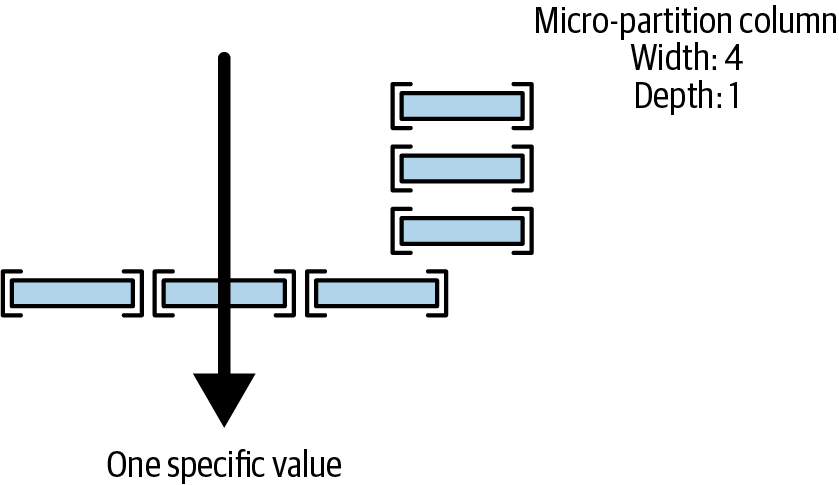
Una clustering key define cómo se agrupan los datos dentro de las micro-partitions.
Definir una Clustering Key
Ejemplo:
ALTER TABLE orders
CLUSTER BY (order_date);
Esto ayuda cuando:
- Se filtra frecuentemente por esa columna
- La tabla es muy grande
- El orden natural de carga no favorece el pruning
El clustering mejora la organización de las micro-partitions.
¿Cuándo usar Clustering?
No siempre es necesario.
Conviene evaluar clustering cuando:
- Tablas superan cientos de millones o billones de filas
- Las consultas filtran consistentemente por las mismas columnas
- El pruning natural no es eficiente
- Existen consultas repetitivas de alto impacto
Snowflake también ofrece automatic clustering, que reorganiza micro-partitions automáticamente (con coste adicional).
Clustering no es indexación
Es importante entender que:
- No crea índices tradicionales
- No añade estructuras adicionales tipo B-tree
- No requiere mantenimiento manual en la mayoría de casos
- Optimiza la organización física interna
Snowflake evita la complejidad clásica de tuning de índices.
Impacto en rendimiento
Un buen clustering:
- Reduce el número de micro-partitions escaneadas
- Mejora tiempo de respuesta
- Reduce consumo de cómputo
- Optimiza costes
Pero un clustering mal diseñado:
- Puede generar sobrecoste
- Puede no aportar mejora real
- Puede ser innecesario
Siempre debe basarse en patrones de consulta reales.
Cómo evaluar si necesitas clustering
Snowflake permite analizar la profundidad de clustering mediante:
SELECT SYSTEM$CLUSTERING_INFORMATION(‘orders’);
Esto devuelve métricas sobre la calidad del clustering.
La decisión debe ser técnica y basada en datos.
Micro-Partitions y arquitectura moderna
La combinación de:
- Micro-partitions inmutables
- Metadatos automáticos
- Data pruning
- Clustering opcional
- Separación storage/compute
permite que Snowflake:
- Escale horizontalmente
- Soporte alta concurrencia
- Reduzca necesidad de tuning manual
- Simplifique la administración
El rendimiento no depende de ajustes manuales complejos, sino del diseño arquitectónico.
Errores comunes
Algunos errores habituales incluyen:
- Intentar “replicar” mentalidad de índices tradicionales
- Forzar clustering sin necesidad
- No analizar patrones de consulta antes de definir keys
- No revisar métricas de clustering depth
- Subestimar el impacto del orden de carga
Snowflake no funciona como bases de datos tradicionales.
Conclusión
Las micro-partitions son el núcleo del rendimiento en Snowflake. Gracias a su diseño inmutable y a los metadatos automáticos, la plataforma puede aplicar data pruning sin necesidad de índices tradicionales.
El clustering es una herramienta adicional que, cuando se utiliza correctamente, puede optimizar consultas en tablas de gran tamaño. Sin embargo, debe aplicarse con criterio técnico y basarse en patrones reales de uso.
Entender micro-partitions y clustering es fundamental para diseñar arquitecturas eficientes y escalables en Snowflake.